AIコードレビューを自動化し、コードの無駄とバグをなくす方法を実演解説
Opus 5.5やFable 5.1、Astraのような最先端のAIモデルは賢いですが、それでも書くコードには無駄やバグが残ります。
ぼくはAIにコードを書かせた後、必ず別のAIのレビューを通していますが、修正が0件で終わることはほぼありません。修正はどれも妥当で、直さないと無駄なコードが増えたり、不具合につながったりするものです。
この記事では、AIの作業が終わるたびにコードレビューとテスト監査を自動で回す仕組みを、実際に作りながら解説します。
今回は、Linter・Formatterとセキュリティを設定した前回の記事の続きで、Webコンテンツ分析アプリを作りながら進めます。
Git worktreeとプルリクエスト(PR)、スキルの知識が前提です。まだの方は、先にGit worktreeでAIの並列作業を実演解説した記事とエージェントスキルの仕組みを解説した記事をご覧ください。
動画で見たい方はこちら。
AIの作業が終わると、レビューからPR作成まで自動で進む
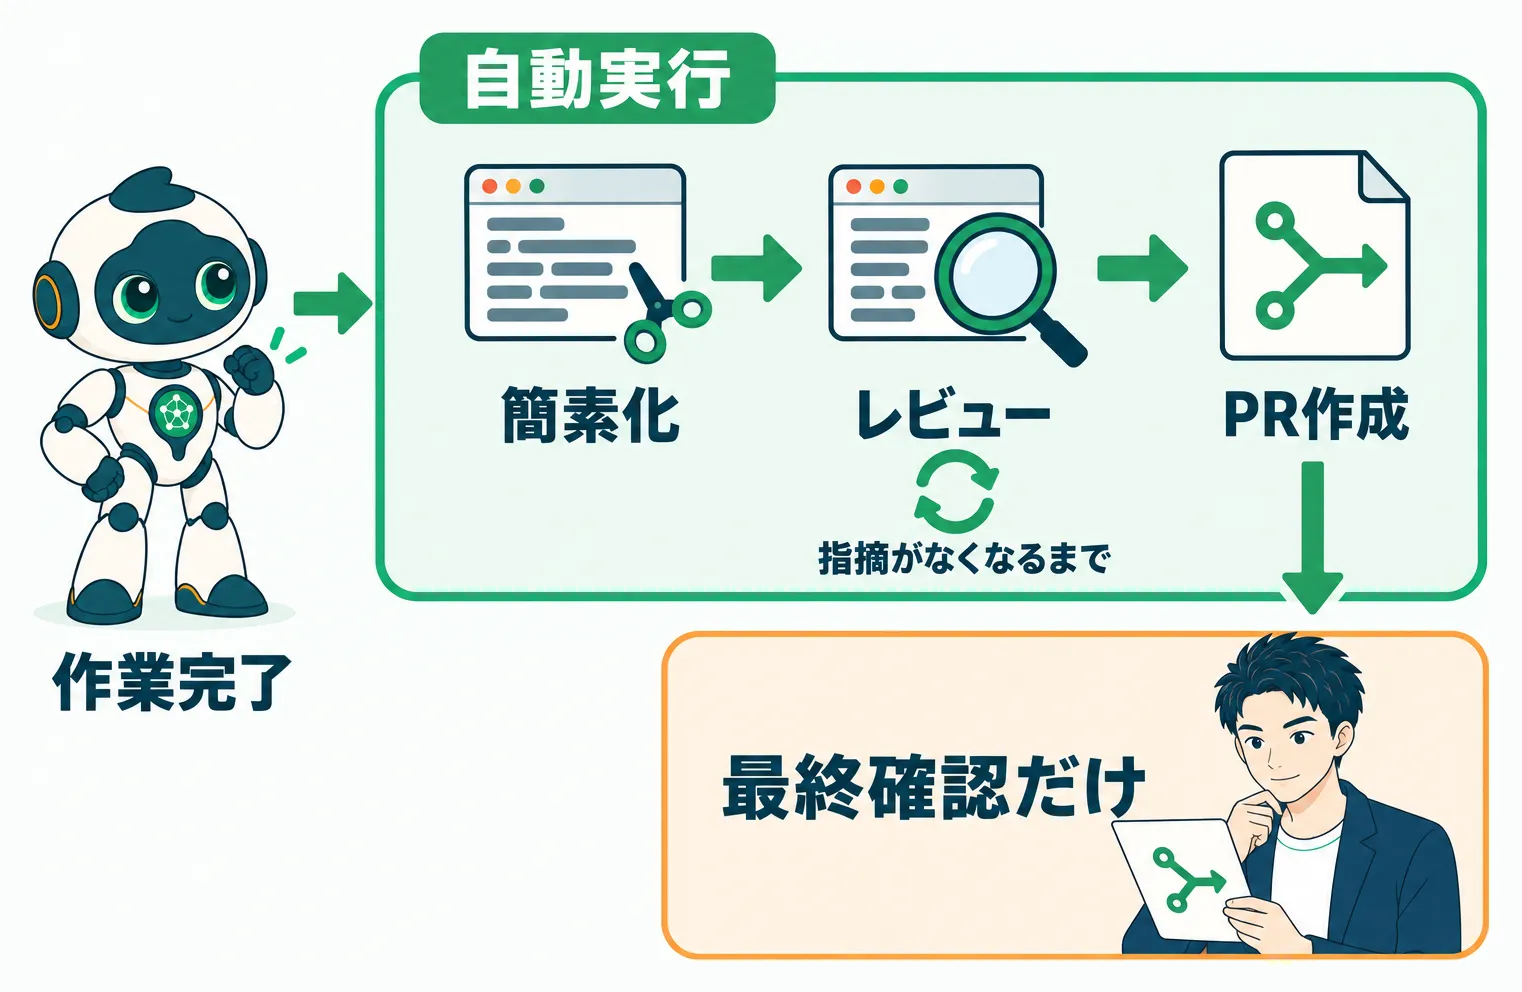
まずは、ぼくが普段やっているAIコードレビューの全体像を解説します。AIが作業を完了すると、以下の流れでレビューからPR作成までが自動実行されます。
- Stopフックで、未コミットの変更があればfinishスキルを実行
- finishスキルでレビューからPR作成までを実行
- Claude Code公式の
/simplifyスキルで、コードの無駄を削除 - Codex公式のreview-agentスキルで、指摘がなくなるまでバグを修正
- コミット、プッシュ、PR作成
- Claude Code公式の
ぼくがやるのは、簡素化とレビューが一通り済んだPRの最終確認だけです。ここからは、各段階を順に解説します。
Stopフックで、AIの作業完了時にレビューを自動開始
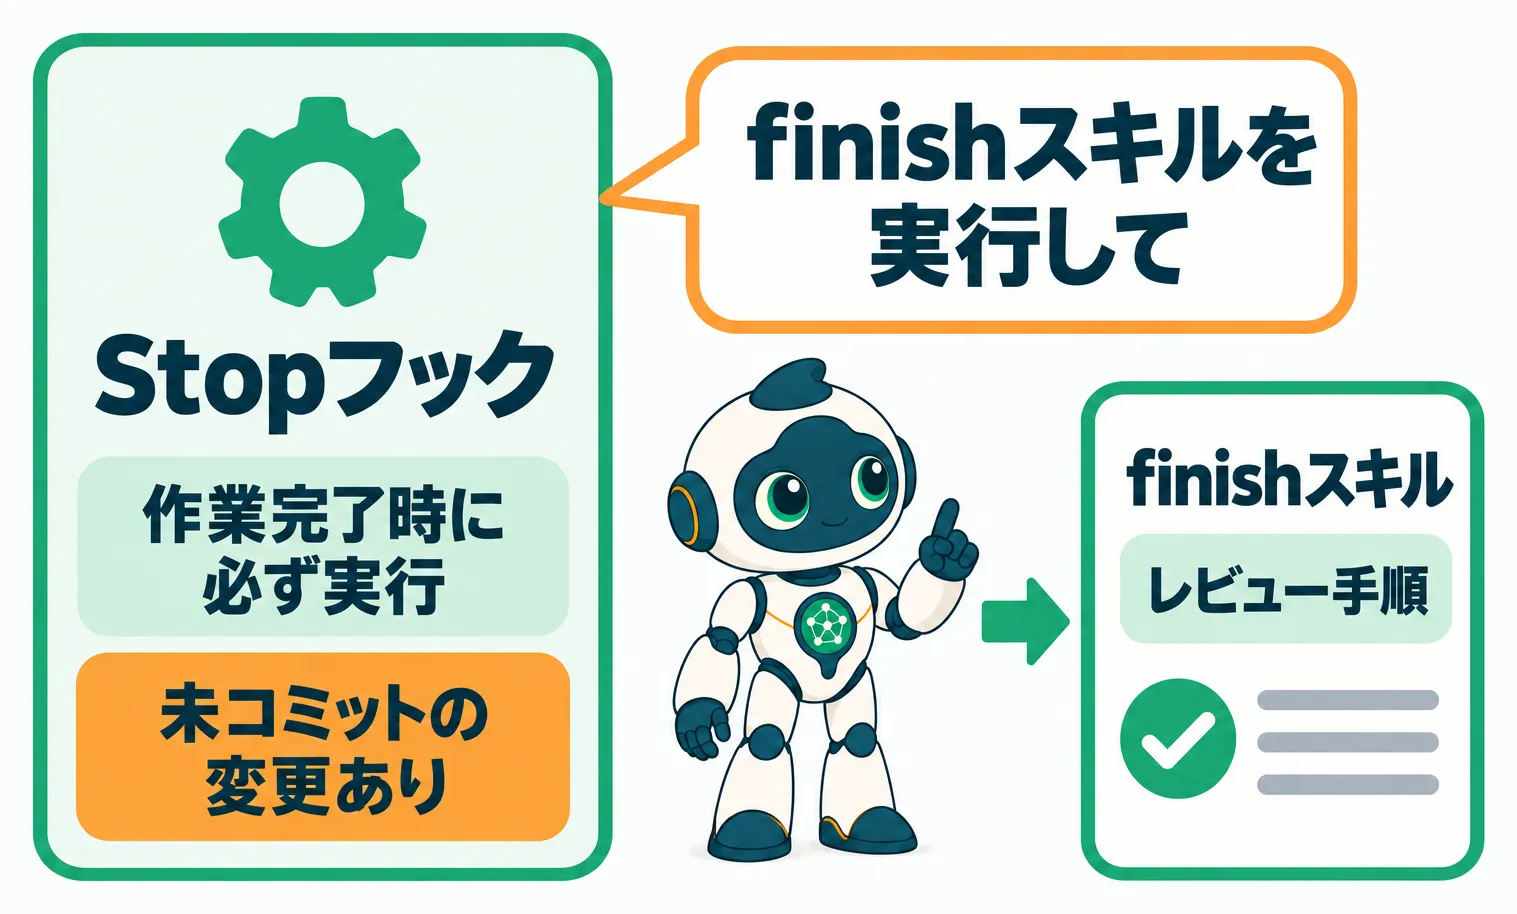
Stopフックとは、AIの作業完了時に必ず実行されるプログラムのことです。Claude Codeだけでなく、Codexにも同じ仕組みがあります。
Stopフックで未コミットの変更を見つけると、プログラムがAIに「作業が完了しているなら、finishスキルを実行して」と指示します。finishスキルには、レビューの具体的な手順が書いてあります。
/simplifyで、コードの無駄を削る
finishスキルでは、まずClaude Code公式の/simplifyで作業内容を簡素化します。同じ処理がすでにあるのにゼロから書いた箇所を既存の処理に置き換えたり、無駄に複雑な条件分岐をシンプルにしたりする機能です。
Codexのreview-agentで、バグがなくなるまで直す
簡素化が済んだら、Codex公式のreview-agentスキルでコードレビューをして、バグを潰します。レビューと修正は、指摘がなくなるまで繰り返します。
スキルは、信頼できる公式のものを使う
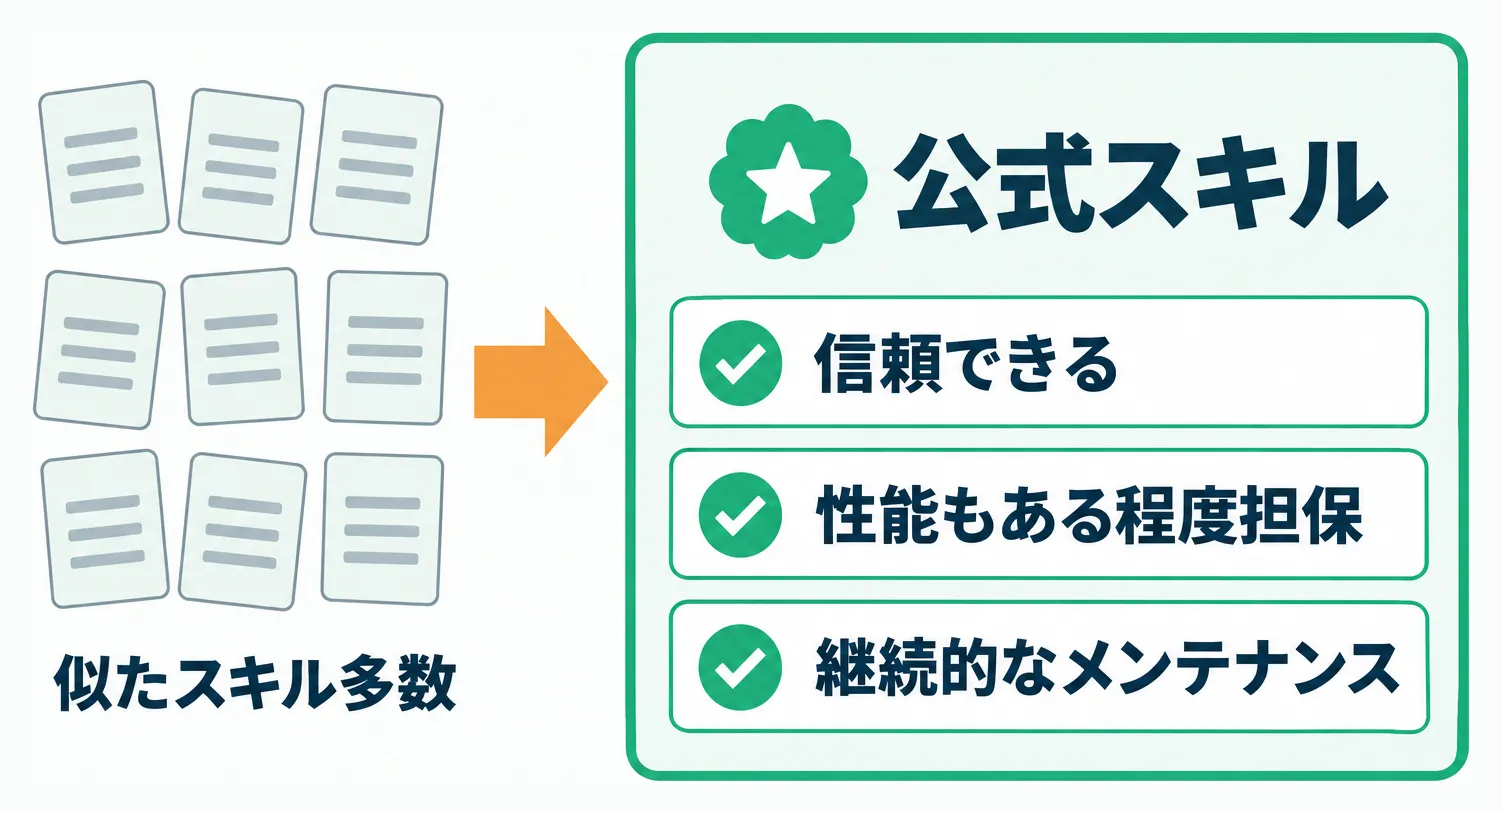
/simplifyやreview-agentに相当するスキルは世の中にたくさんありますが、基本は公式のものを使うべきです。信頼でき、性能もある程度担保され、継続的なメンテナンスも期待できるからです。
Claude Codeでレビューの仕組みを作成
では早速、レビューの仕組みを作ります。
レビューでは、Claude CodeからCodexのCLI版を呼び出してレビューさせます。CodexのCLI版は、ChatGPTのPlusプラン(月3,000円、2026年10月20日時点)から使えます。
レビューの仕組みをClaude Codeに作らせる指示は以下です。モデルはOpus 5.5、思考レベルは「最大」にました。
コードレビューからPR作成までを自動化して。Stopフックで未コミット差分があったら、これから作成するfinishスキルを呼ぶ。finishスキルの内容は以下
1. `/simplify`を実行
2. `codex exec review`を実行
3. レビュー指摘がなくなるまでレビューと修正を繰り返す、ただし、ミリ秒単位の競合など、現実的には問題にならないレビュー指摘は却下する
4. 上記工程が完了したら、commit、push、PR作成をする
現実的には問題にならない指摘は、却下させる
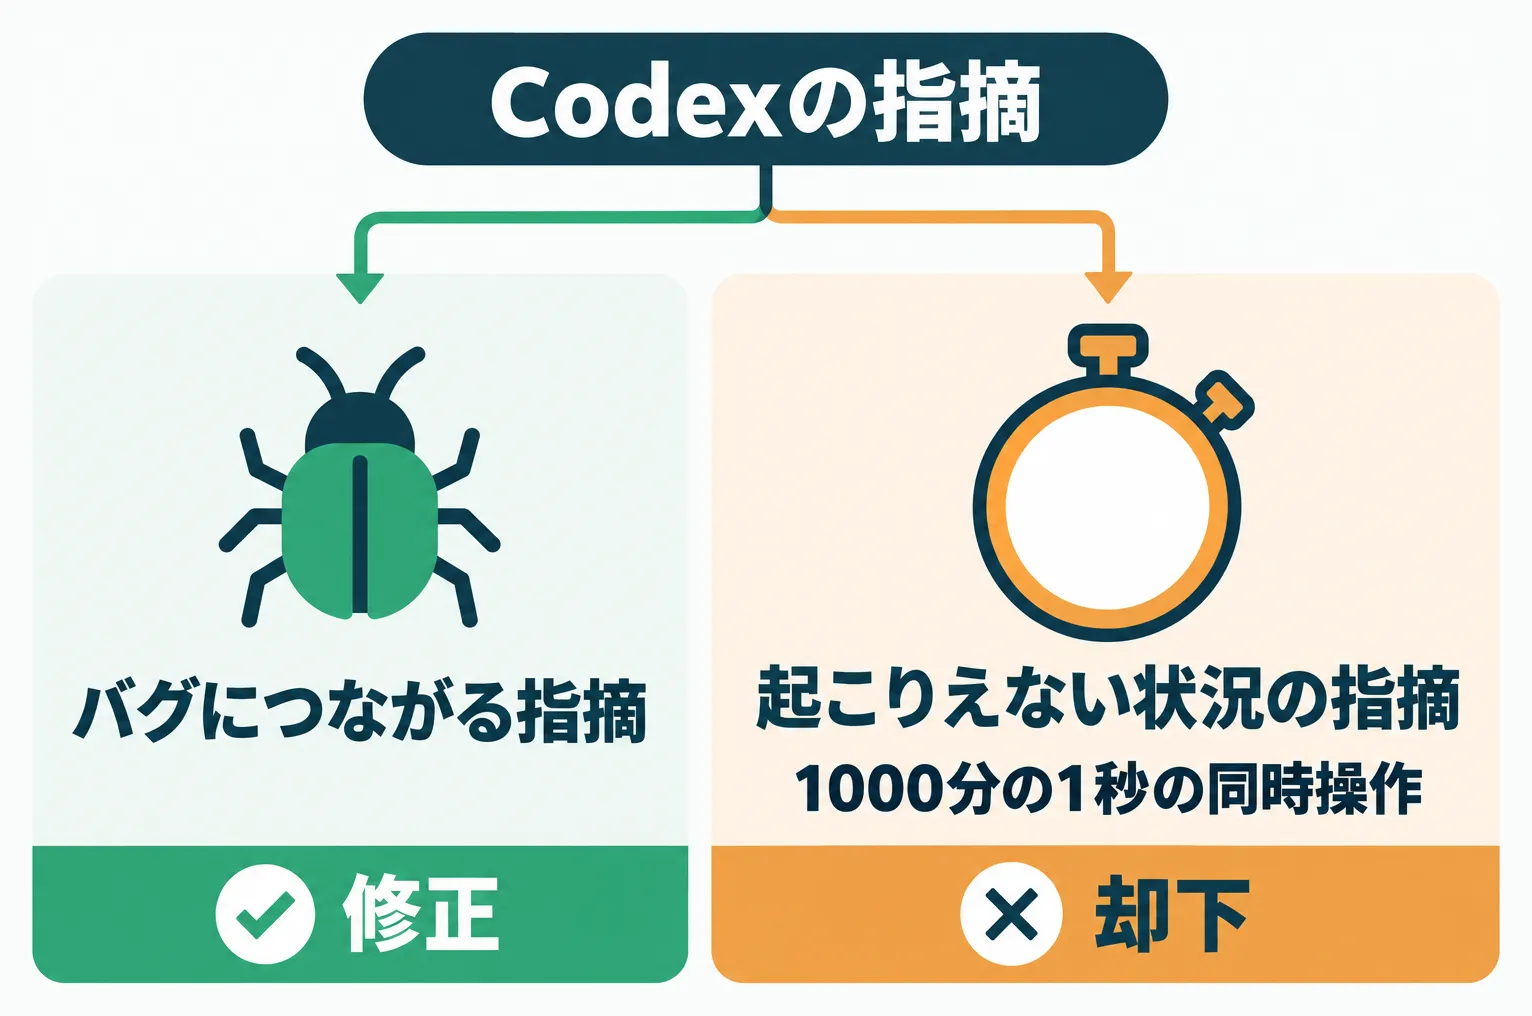
3番目のただし書きは、ぼくがこれまでCodexのレビュー機能を使ってきた経験から足した指示です。
Codexのレビューは、バグにつながる指摘もしますが、1000分の1秒単位で同時に特定の操作をした場合など、実際には起こりえない重箱の隅をつつく指摘もよくします。
そうした細かすぎる指摘は、却下するようスキルに組み込んでおきます。
Stopフックとfinishスキルが完成
指示への対応が完了しました。作られたPRの説明欄に、Stopフックとfinishスキルの手順がまとまっています。
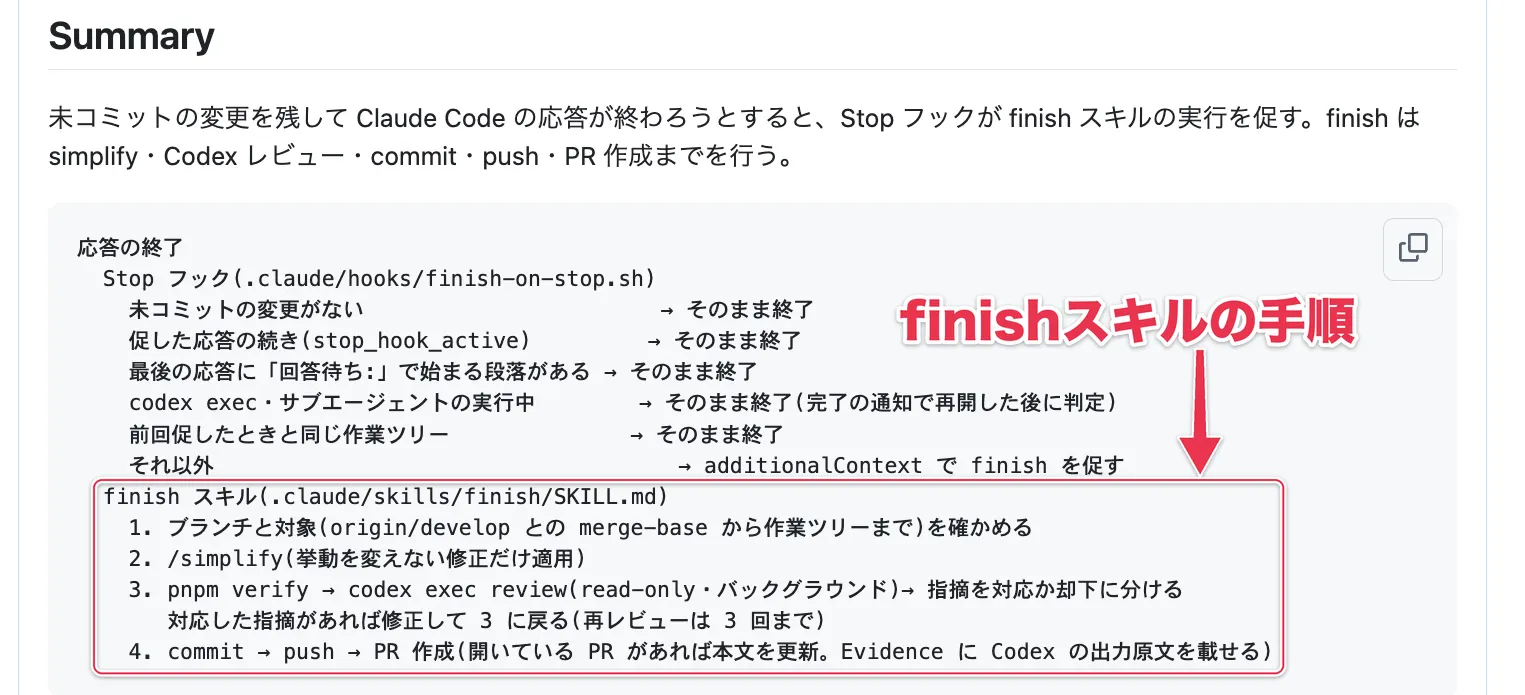
これで、AIが作業を完了するたびに、自動でレビューからPR作成まで実行されます。
作業ごとにworktreeを作ると、AIレビューの見落としが減る
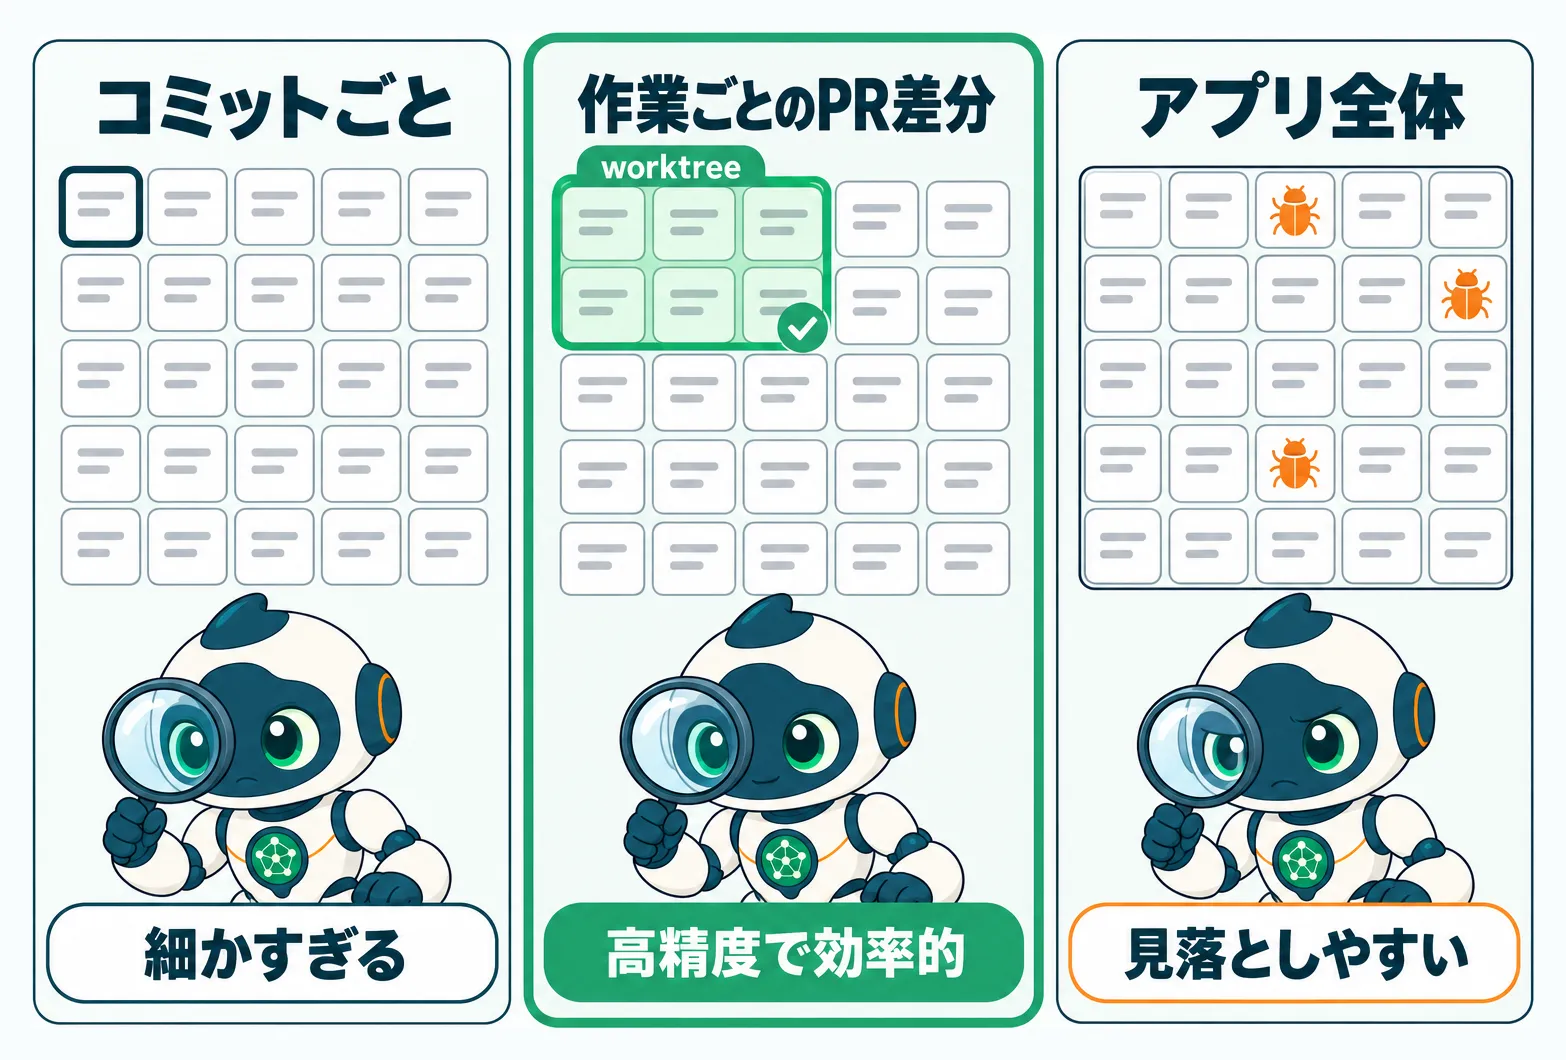
ぼくはアプリ開発をするとき、必ず開発用のdevelopブランチから、1つの作業ごとにworktreeを作って対応しています。AIによるコードレビューの質を高めるためです。
作業ごとにworktreeを作ってPRを出せば、AIがレビューする対象はその作業の差分だけになります。/simplifyもCodexのレビューも、範囲を適切に絞れば見落としを減らせます。
1回のコミットごとのレビューは細かすぎ、かといってアプリ全体を定期的に一気にレビューさせると、見る範囲が広すぎて見落としが起きやすくなります。
作業単位でworktreeを作り、その作業のPRの差分だけをレビューさせるのが、AIレビューを最も精度高く効率的に実行する方法です。
Webコンテンツ分析アプリの開発で、レビューの仕組みを試す
Webコンテンツ分析アプリの開発を進め、レビューの仕組みがうまく動くかを確かめます。アプリのDBまわりの対応をClaude Codeに任せました。
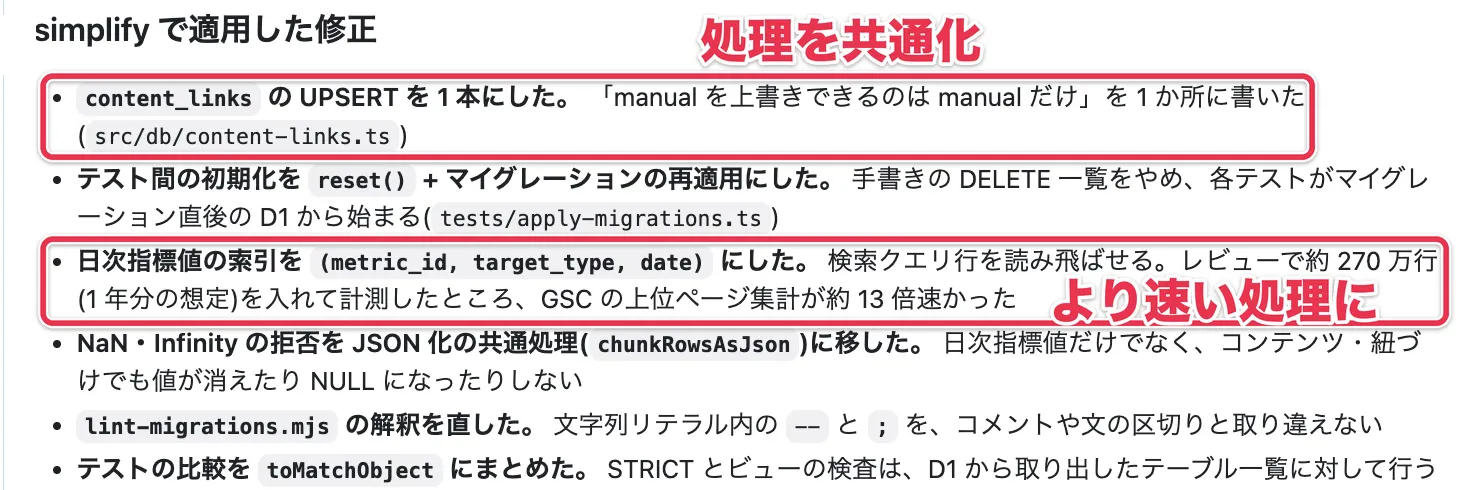
/simplifyは、処理の共通化や、より速い処理への置き換えをした
対応が完了し、PRの説明欄の「simplify で適用した修正」を見ると、/simplifyがちゃんと適用されています。処理を共通化したり、より速い処理方法を採用したりしていました。
Codexの指摘は、Claudeが妥当性を判断して対応した
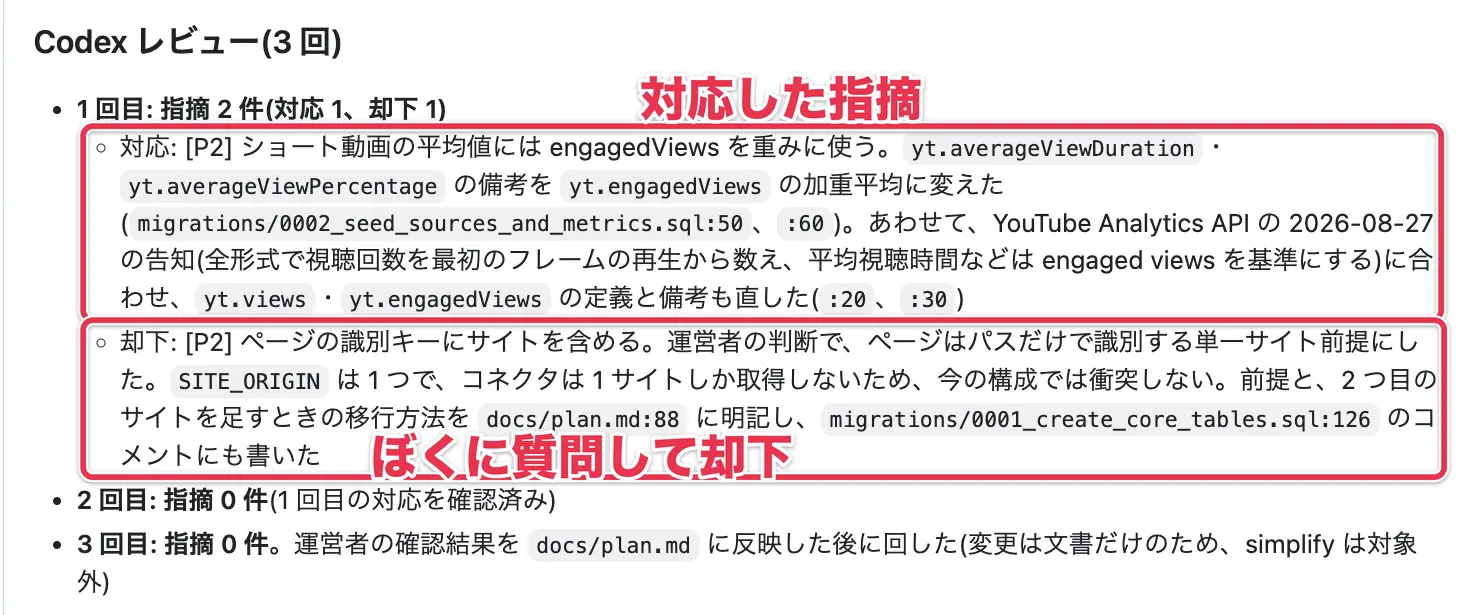
Codexによるレビューも、ちゃんと実行されています。指摘の妥当性はClaudeが判断し、対応が必要なものは直し、不要なものは却下しています。
今回却下した指摘は、Claude自身では判断できなかったため、ぼくに質問してから判断しました。
高性能なAIモデルでも、書くテストの質はイマイチ
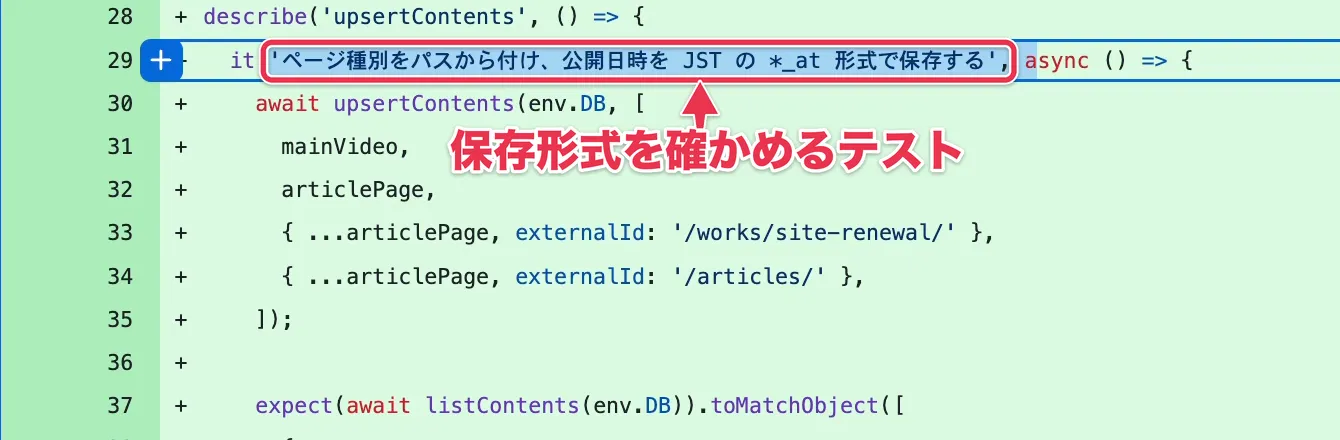
AIはコードを書くと、その動作が正しいかを確かめるテストも一緒に書きます。たとえば、データベースへの保存処理が、期待される形式で保存されているかを確かめるテストです。
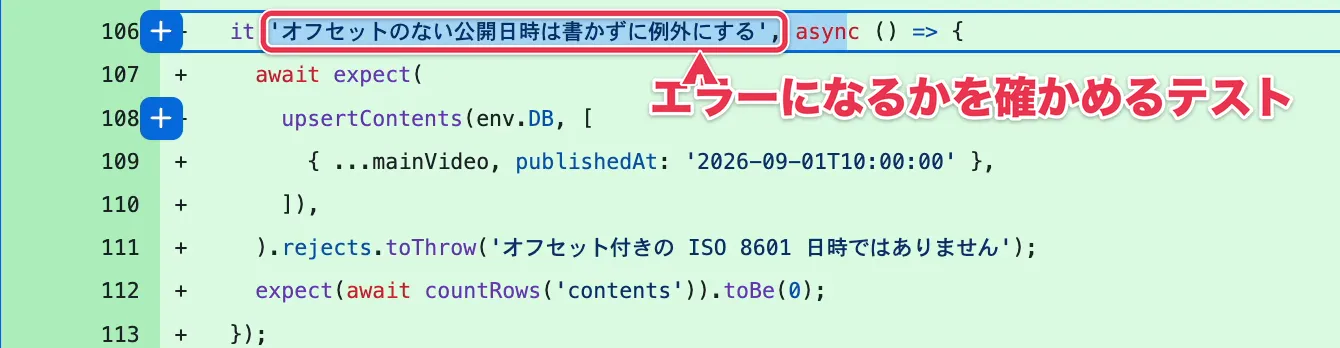
エラーになるべきときに、ちゃんとエラーになるかを確かめるテストも書きます。
ただ、Opus 5.5やFable 5.1のような高性能モデルでも、テストの質はイマイチです。
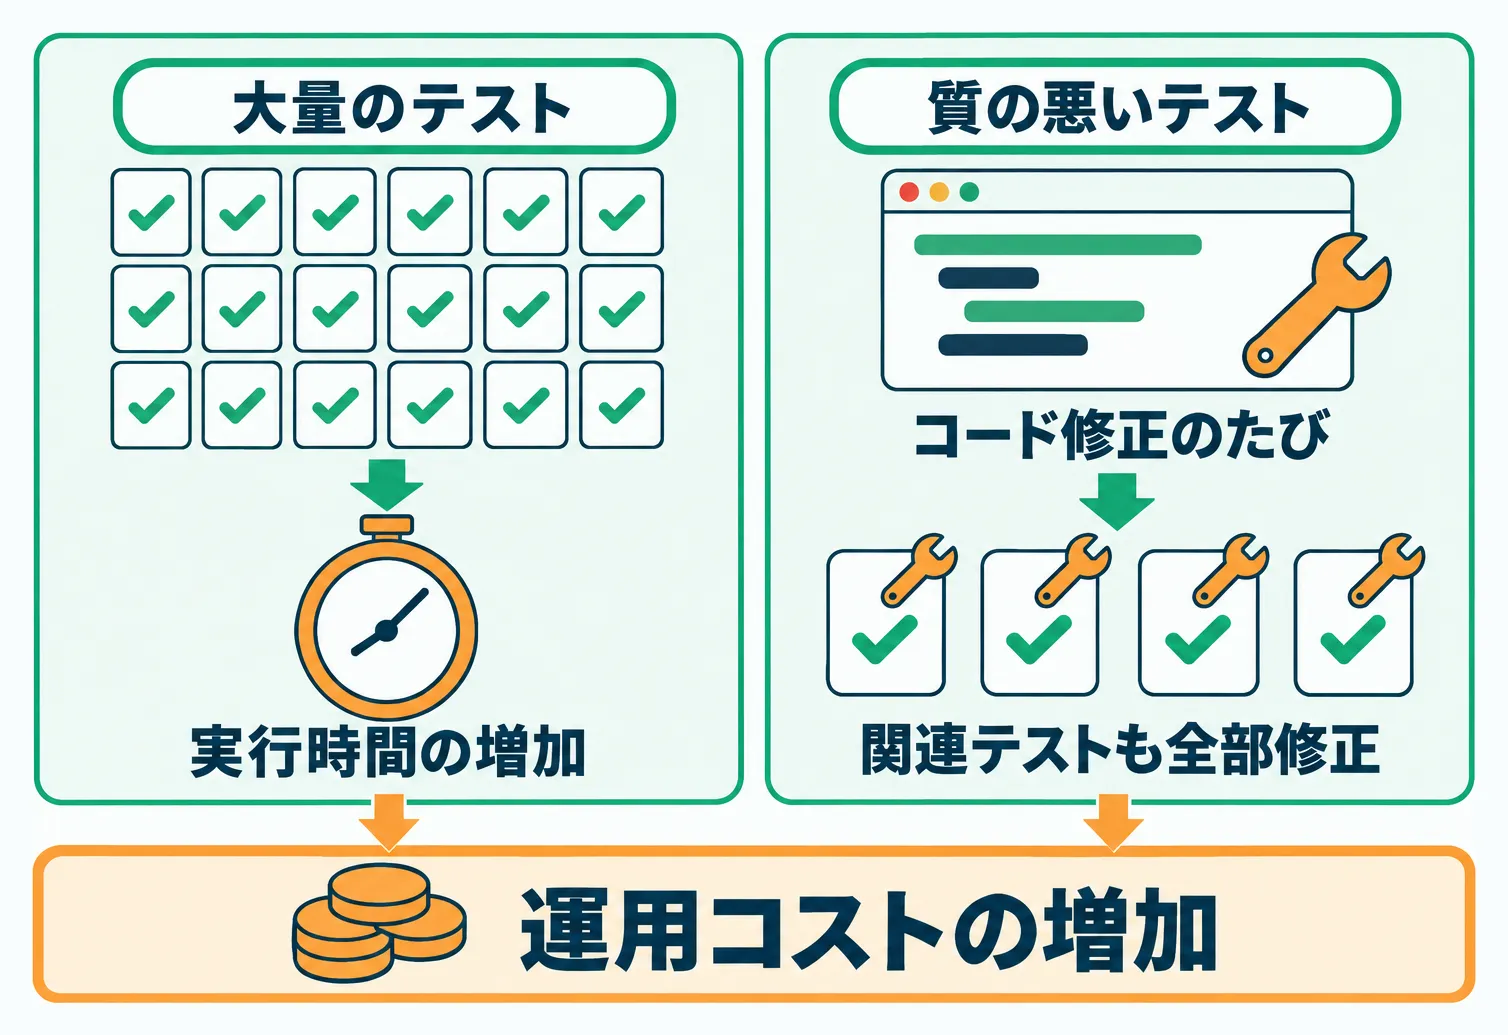
テストは、たくさん書けばいいものではありません。多いと実行に時間がかかり、品質の悪いテストはコードを直すたびに関連するテストもすべて直す必要があって、運用コストがかかります。
良いテストとは、コードが壊れたときに気付けるテスト
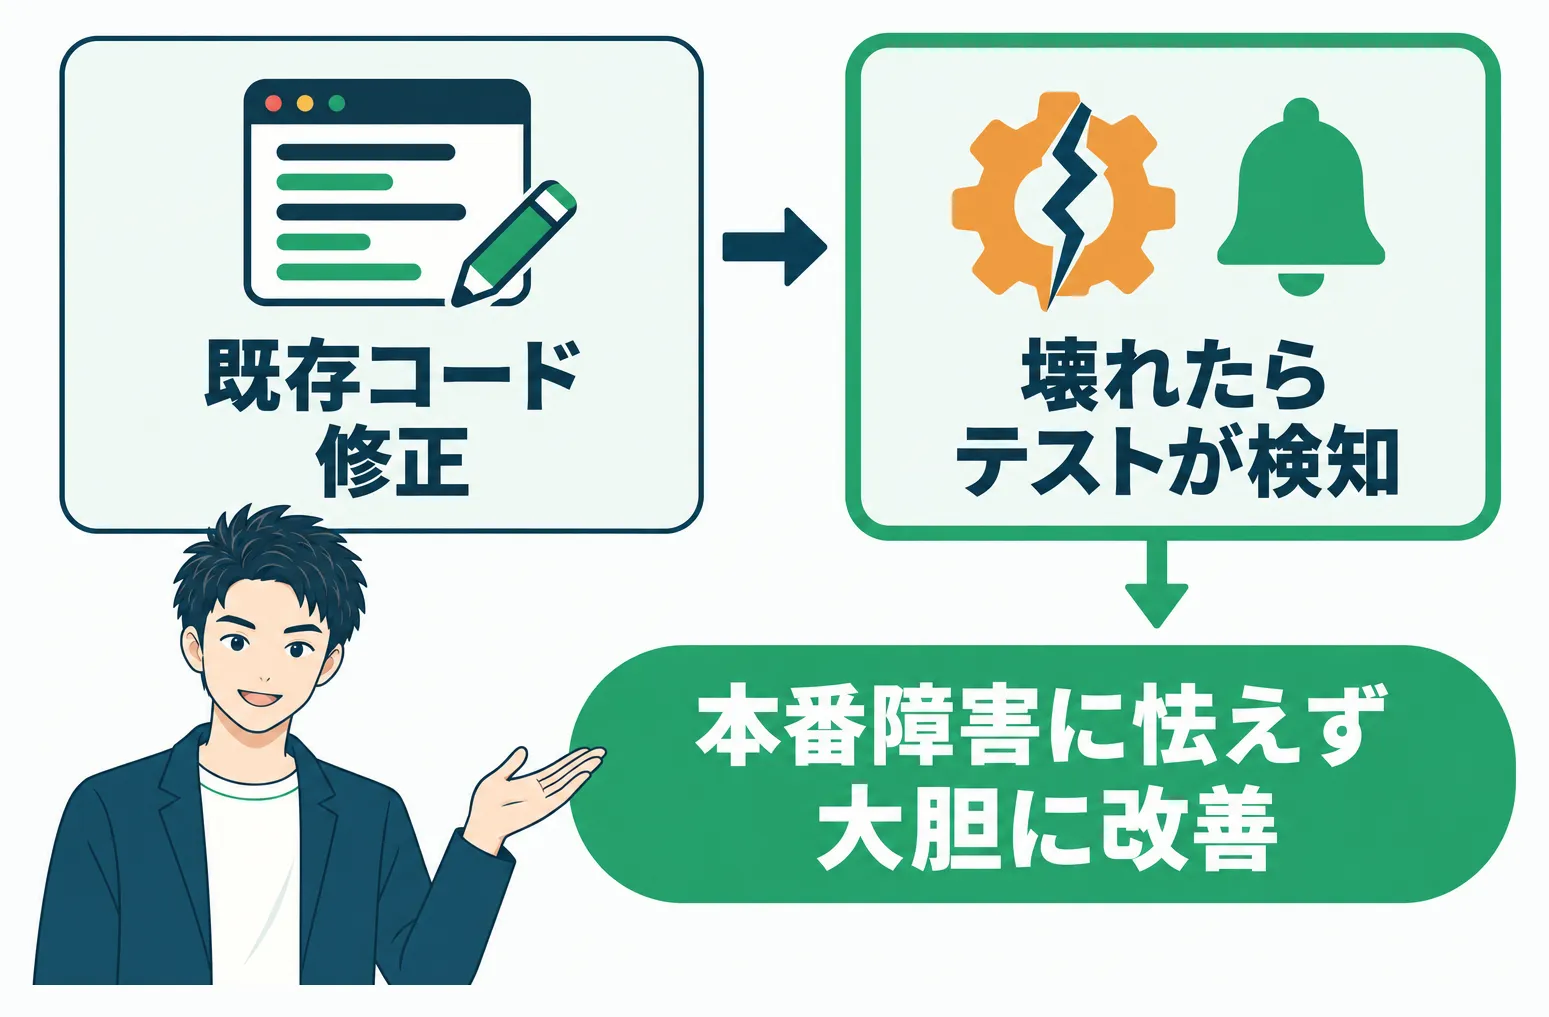
いろいろなパターンを網羅的に確かめていることや、実行時間が短いことも確かに大事です。でも、品質の良いテストで一番大事なのは、コードが壊れたときに気付けることです。
アプリ開発では、機能追加や改善で既存のコードを直すことがよくあります。そのときに、もともと動いていた機能が壊れたら、ちゃんと検知できるのがいいテストです。
壊れたら検知できるテストがあれば、修正で起きる本番障害に怯えずに済むので、アプリの改善を大胆にできます。
OpenClawのテスト監査スキルは、コードを壊してテストの価値を確かめる
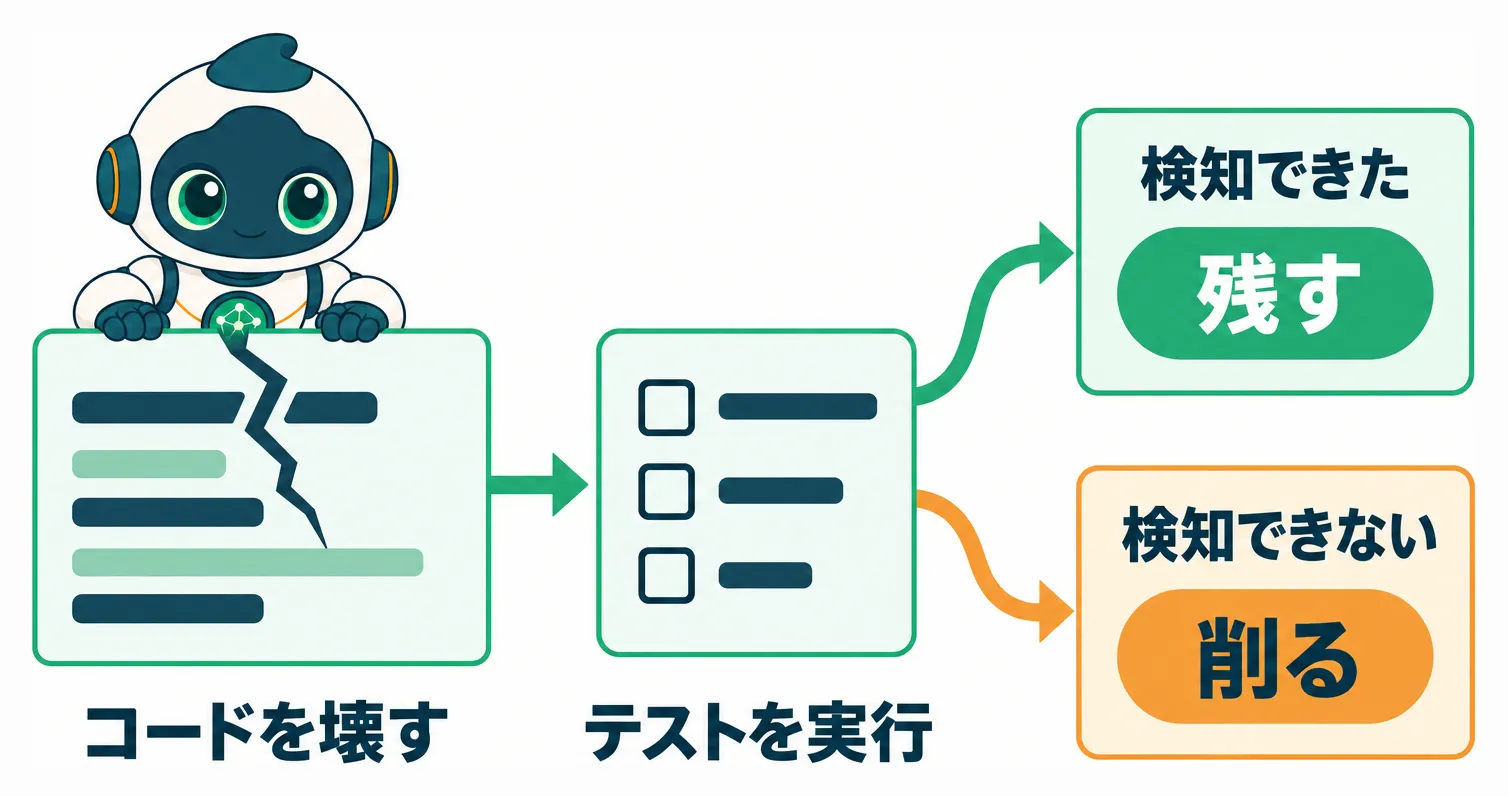
この「壊れたら気付ける」というテストの価値を重視して、AIが書くテストを監査するスキルがあります。それがOpenClawのテスト監査スキルです。
OpenClawは、2026年前半に一世を風靡したAIエージェントアプリです。開発者のピーター・シュタインバーガーさんは、今はOpenAIの開発チームにいる実力者です。
そんな彼が自身のOpenClawで使っているテスト監査スキルが、GitHubで公開され、継続的にメンテナンスされています。MITライセンスで、誰でも無料で使えるスキルです。
このスキルは、テストが確かめている対象のコードを実際に壊し、テストがその故障を検知できるかを確かめて、テストの価値を判断します。
だからこそ、AIが作りがちな無駄なテストはどんどん削り、テストがないとコードが壊れたことを検知できない箇所にはテストを増やします。ぼくもほかのプロジェクトで、いつも使っています。
テスト監査スキルを導入
早速、Claude Codeにテスト監査スキルを入れてもらいます。
https://github.com/openclaw/openclaw/tree/main/.agents/skills/test-audit のスキルを入れて。ただし、このスキルはopenclaw向けに作られたものなので、このプロジェクトに最適化して。テスト監査はfinishスキルに組み込んで
テスト監査スキルはOpenClaw用に作られたもので、OpenClawに関する記述があります。そのため、導入するときは自分のプロジェクト向けに最適化させます。
さらに、先ほど作ったfinishスキルに組み込めば、AIの作業完了時に自動でテスト監査スキルも行われます。
テスト監査スキルが、finishスキルに組み込まれた
テスト監査スキルの導入も完了しました。プロジェクト向けに最適化したテスト監査スキルを追加し、finishスキルのレビューの手順にも組み込んでくれました。
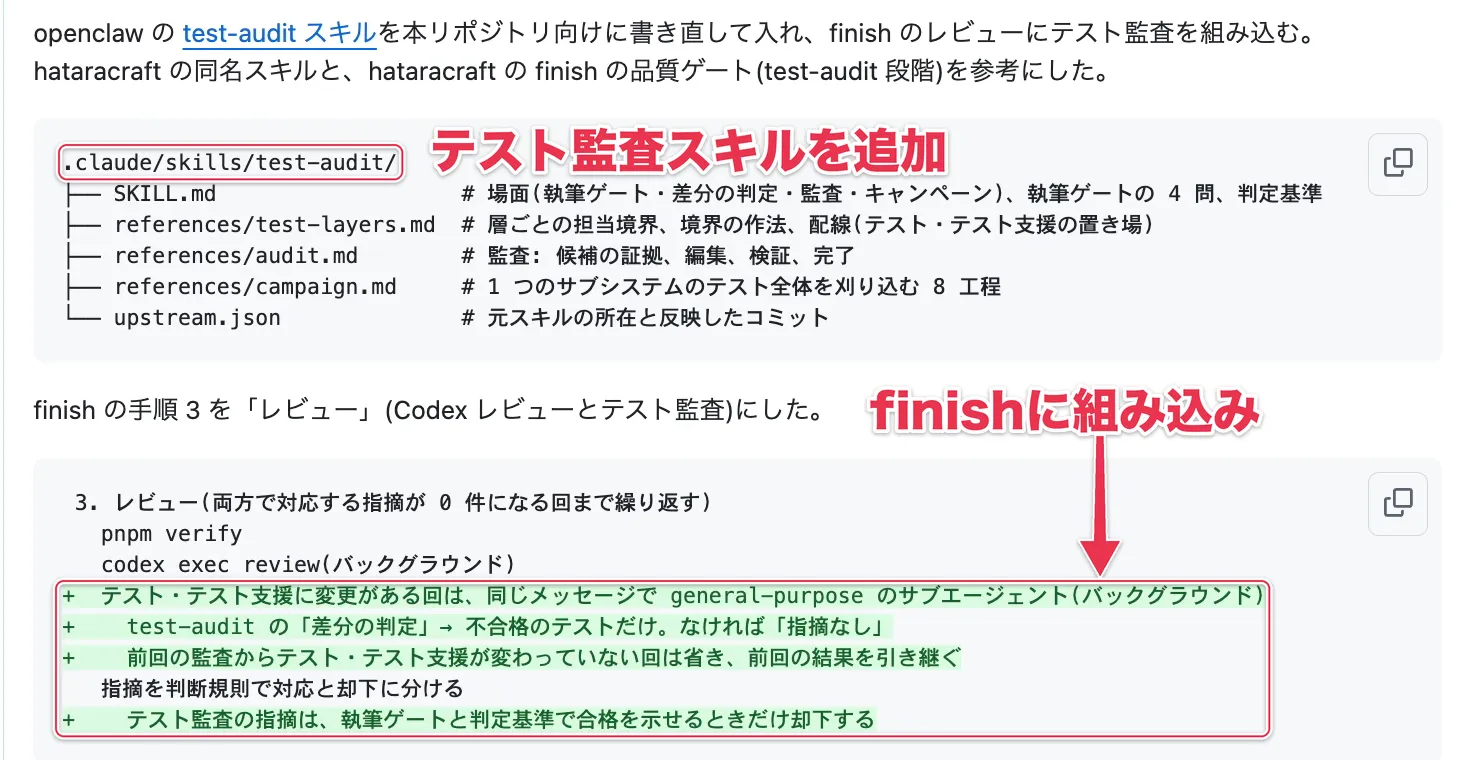
これで、テストに修正があるときは、finishスキルの中でテスト監査も通ります。
テスト監査は、無駄なテストを削り、壊れたときに気付けるテストを残す
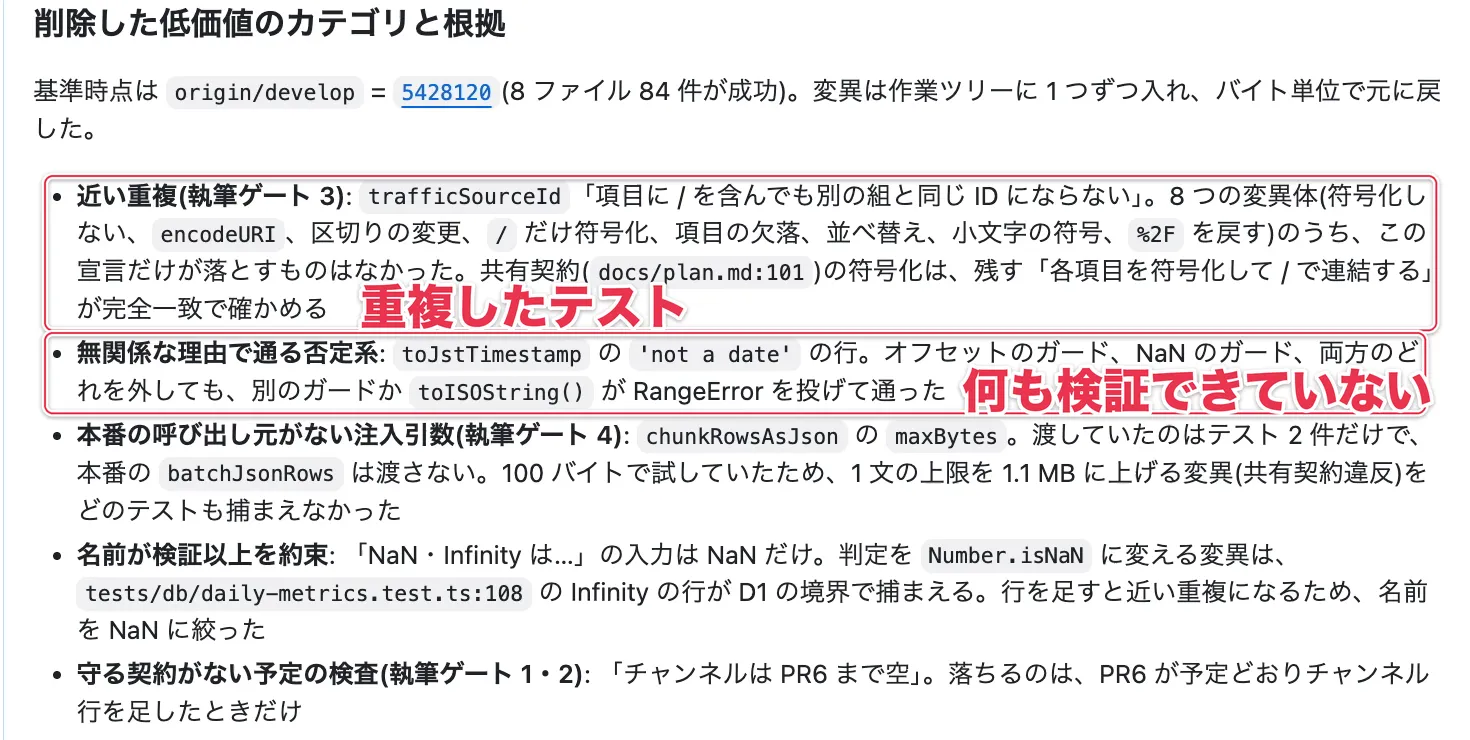
実際にテスト監査スキルを実行してみました。重複したテストや、何かを確かめているようで実際は何も検証できていないテストなど、無駄なものをすべて削っています。
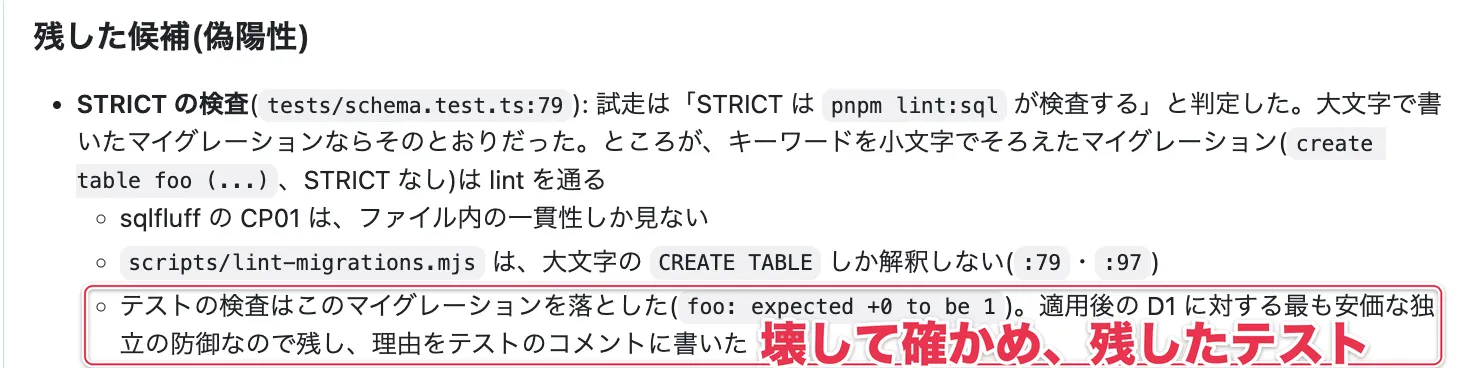
一方で、それがないとコードが壊れたときに検知できないテストは、コードを壊して確かめたうえで残しています。
まとめの前に、お知らせを。
業務のAI活用の個別サポートや、研修・システム開発などのお仕事は、公式LINEからお問い合わせください。相談は無料です。
記事の内容やその他のご質問も、公式LINEで回答しています。
 はたらクラフト公式LINELINElin.ee
無料メルマガで実務で使えるAI活用を毎日配信中。1分で登録できます。
 超実践AI論Substacktaichiaiworker.substack.com
まとめ:AIの作業完了時に、コードレビューとテスト監査を自動で通す
この記事の要点は次の6つです。
- 最先端のAIモデルでも一発で書いたコードには改善点があるため、AIによるコードレビューを入れる
- Stopフックで、AIの作業完了時に必ずfinishスキルを呼ぶ
- finishスキルでは、
/simplifyで無駄を削り、Codexのレビューでバグを潰してからPRを作る - テストの修正があるときは、OpenClawのテスト監査スキルで壊れたときに気付けるテストを残す
- 作業ごとにworktreeを作り、PRの差分だけをレビューさせる
- レビューで実行時間とトークンは増えるが、長く運用するアプリならトータルのコスト・作業時間・品質のすべてが良くなる
ぜひあなたのアプリでも、今回の内容を参考に、AIによるコードレビューの自動化を試してみてください。コードやテストの無駄がなくなり、バグも潰せます。
この記事をシェア