賢いAIほどスキルは削るべき。注意・判断・検証の3つを減らす
AIにいい仕事をさせるため、エージェントスキルに注意や検証をどんどん書き足してきた方は多いと思います。
しかし、Claude Fable 5やGPT-6 Astraのような賢いモデルには、仕事のやり方を細かく指示されるのは邪魔にしかなりません。
AnthropicやOpenAIも、AI向けの細かい手順を削ることを推奨しています。
そこで、この記事では以下の内容を解説します。
- 賢いモデルに細かい手順が邪魔になる理由
- 削るべきは注意・判断・検証の指示
- スキルをスリム化する具体的な手順
動画で見たい方はこちら。
賢いモデルには、細かい手順がかえって邪魔になる
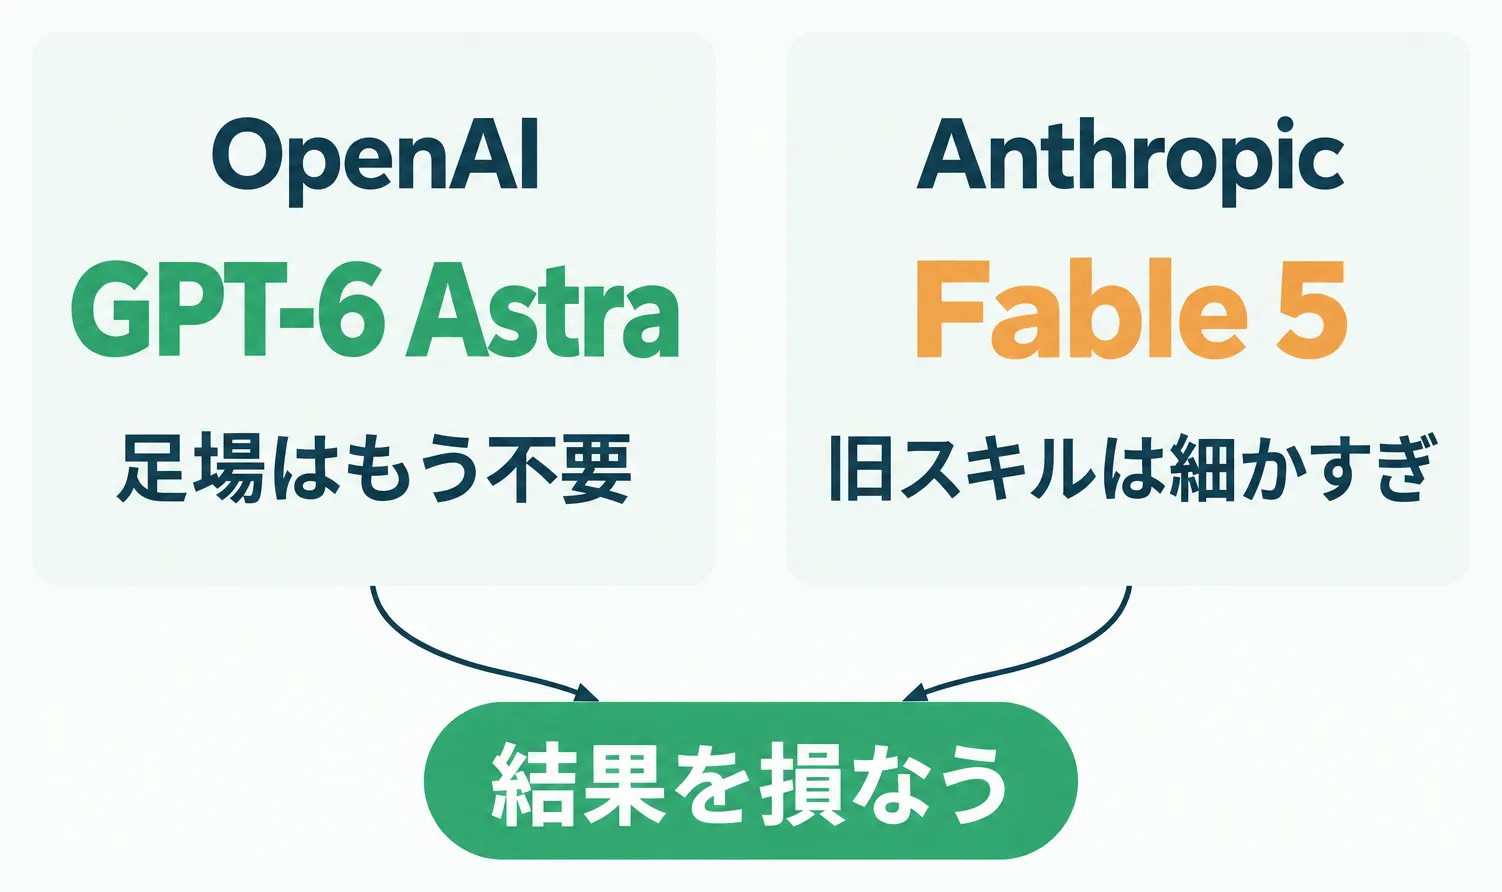
OpenAIは公式ブログ「Rethinking skills and prompts for GPT-6 Astra」で、有能なモデルには、以前は必要だった手取り足取りの足場がもう要らないと明記しています。
現在のモデルは、曖昧さや意味の理解が格段に向上しました。そのため、細かすぎる指示は以前は役立った場面でも、かえって結果を損ないます。
AnthropicもFable 5の公式ドキュメントで、旧モデル向けに作られたスキルはFable 5には細かすぎることが多く、出力の品質を落としうると明記しています。
やっかいなのは、この細かく書きすぎる問題が、AstraやFable 5自身にスキルを書かせたときにも起きることです。
検証の指示は自己検証と二重になり、トークンを浪費する
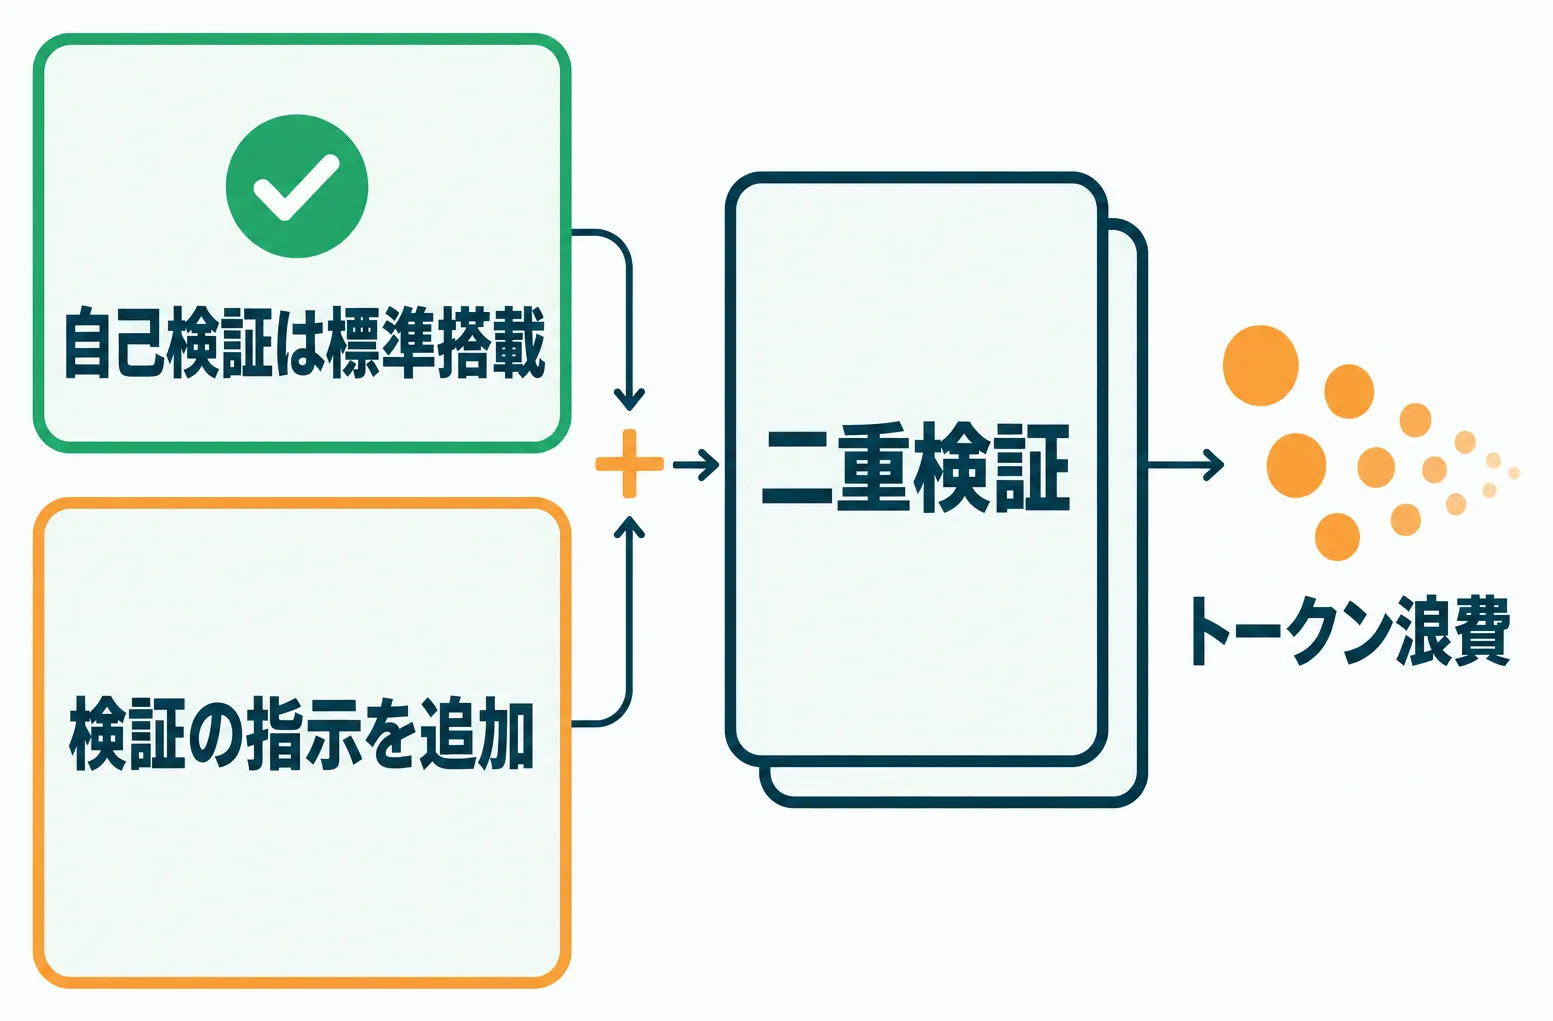
旧モデルでは、サブエージェントなどによる検証をやらせないと、成果物の品質を担保できませんでした。ぼくもそのために、スキルへ検証の手順を書いてきました。
しかし、Astraはもともと自分で検証をするよう設計されています。
旧モデルにはテストや確認を促す必要があったが、Astraは自分で検証をする。そのため、検証の指示は不要なテストにつながる、というのがOpenAIの説明です。
Anthropicの「Prompting Claude Opus 5」にも、Claude Opus 5は指示されなくても自分の仕事を検証すると明記されています。
つまり、賢いモデルに検証を指示すると、自己検証と指示された検証を二重にやり、トークンを浪費します。
理想の指示は「望む結果を出す最小の言葉」
Anthropicは「Effective context engineering for AI agents」で、良いコンテキスト(AIに与える情報の)設計を次のように定義しています。
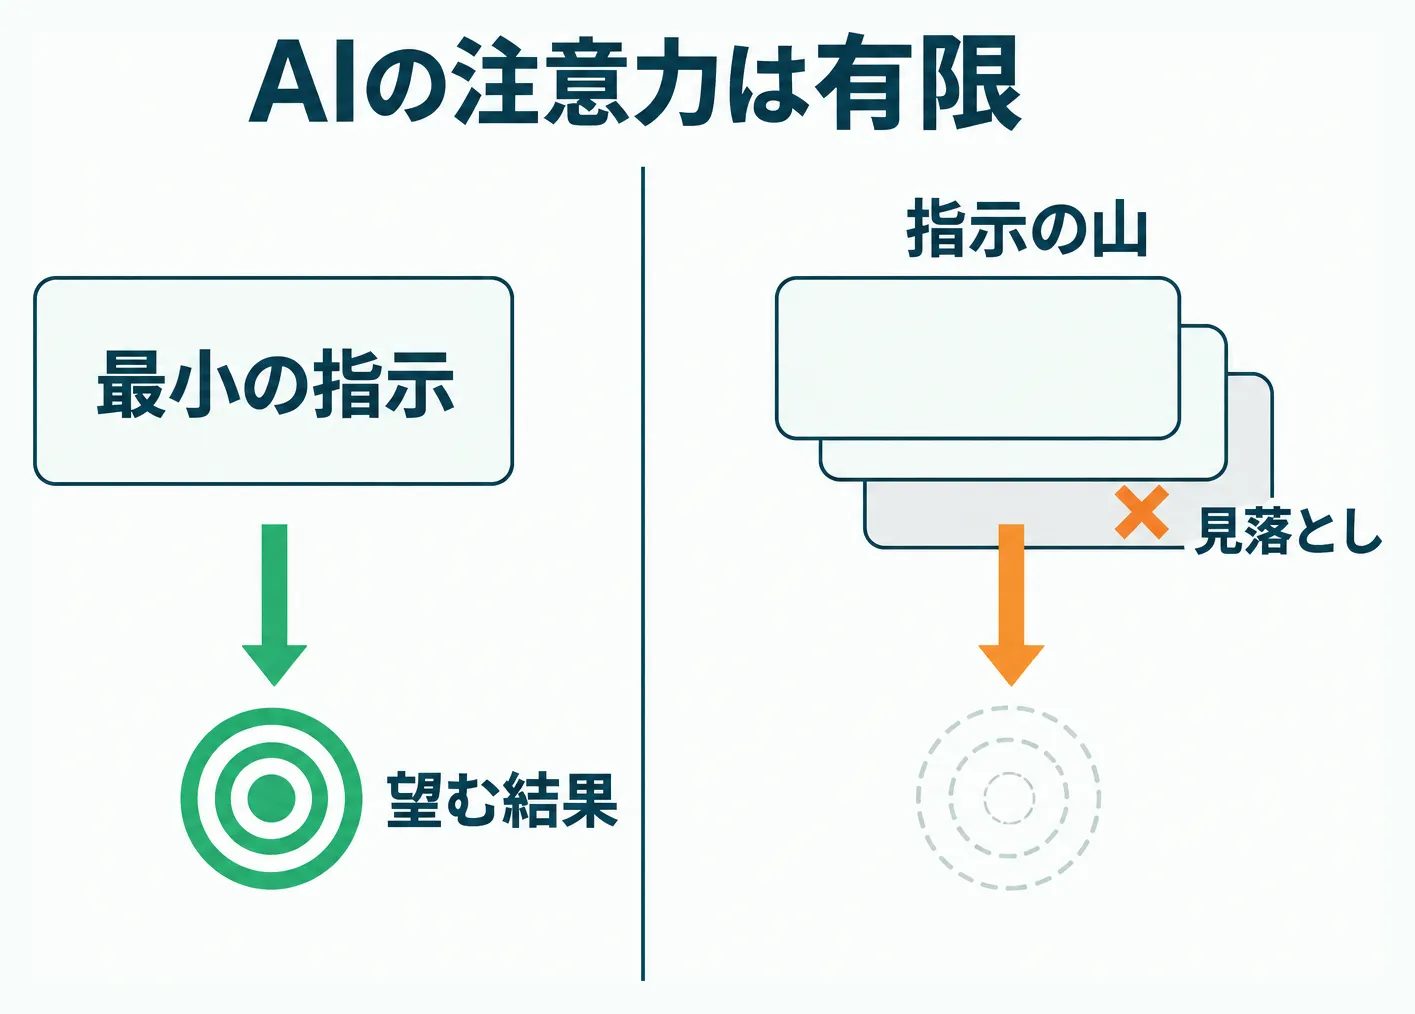
「望む結果の確率を最大にする、最小の高信号トークン集合を見つけること」。つまり、AIへの理想的な指示とは、できるだけ短い言葉で望ましい結果を出させるものだということです。
AIの注意力は有限なので、指示を1つ足すごとに、AIが指示を無視したり見落としたりする確率は上がります。
Anthropicは、まず最小のプロンプトを試し、初期テストで見つかった失敗に応じて指示や例を足していくのが最善だと案内しています。
AIにはまず、できるだけ短くシンプルな指示を出し、結果を見ながら少しずつ足していくのがベストです。
削るのは注意・判断・検証
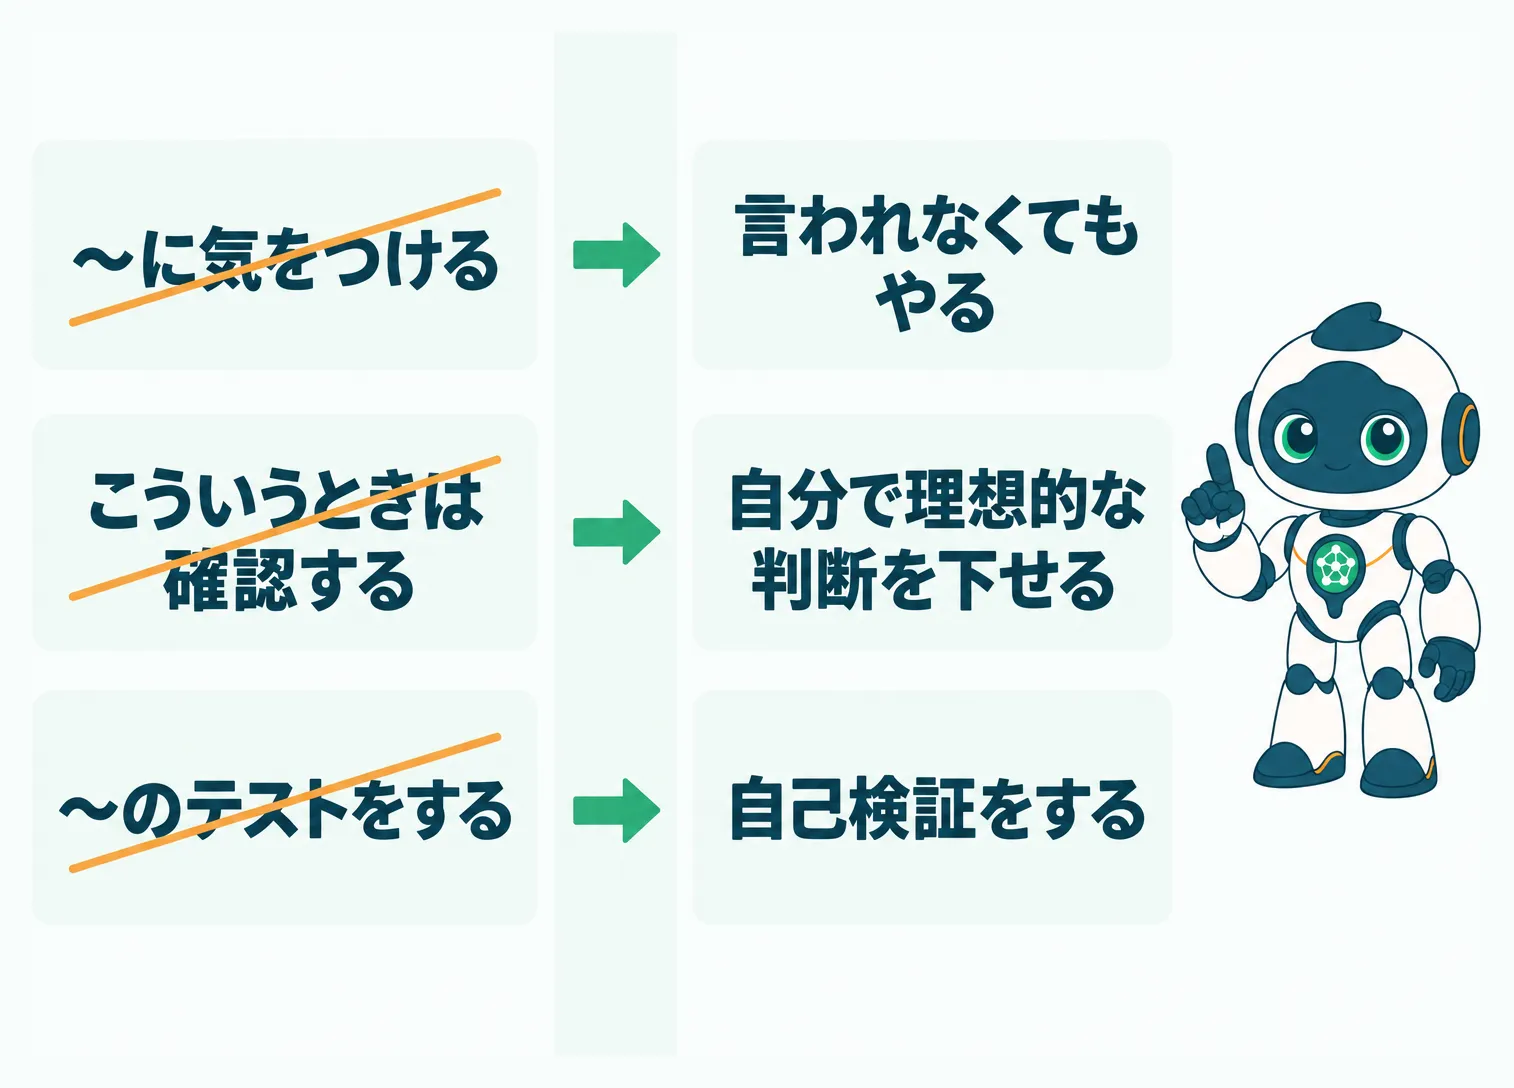
賢いモデルのために削るべきは、注意・判断・検証の指示です。
- 注意: 「〜に気をつける」「〜しないこと」といった指示。賢いモデルなら、言われなくてもやる
- 判断: 「こういうときは確認する」「〜なら中断する」といった指示。賢いモデルなら、自分で理想的な判断を下せる
- 検証: 「〜のテストをする」「〜のチェックをする」といった指示。前章のとおり、賢いモデルは自己検証をする
判断について、OpenAIはAstraを、判断力が高く安全だと分かるまで作業を実行しないモデルだと説明しています。
旧モデル向けの強い制止の文言を残すと、Astraはそれを真に受けて、続けてよい場面でも止まってしまいます。
最適化はAIへの指示1つ。OpenAI公式ブログのリンクを渡す
注意・判断・検証を削ってスキルをスリム化するのは簡単です。OpenAIのAstra向け公式ブログのリンクを渡し、AIに次のように依頼するだけでOK。
https://developers.openai.com/blog/rethinking-skills-and-prompts-for-gpt-6-astra の内容に沿って、`スキル名` のスキルを最適化してOpenAIのブログ自体も、末尾で「この記事の内容に基づいてAstraに監査させる」ことを勧めています。
最適化するスキルによっては、行数が半分以下に減ることもあります。それだけスリムになれば、トークンも実行時間も管理コストもかなり節約できます。
ちなみに、Astra向け公式ブログを使ったプロジェクト全体の見直し方法は、別の記事で解説済みです。
削ったら1回使って確認し、劣化したらGitで丸ごと戻す
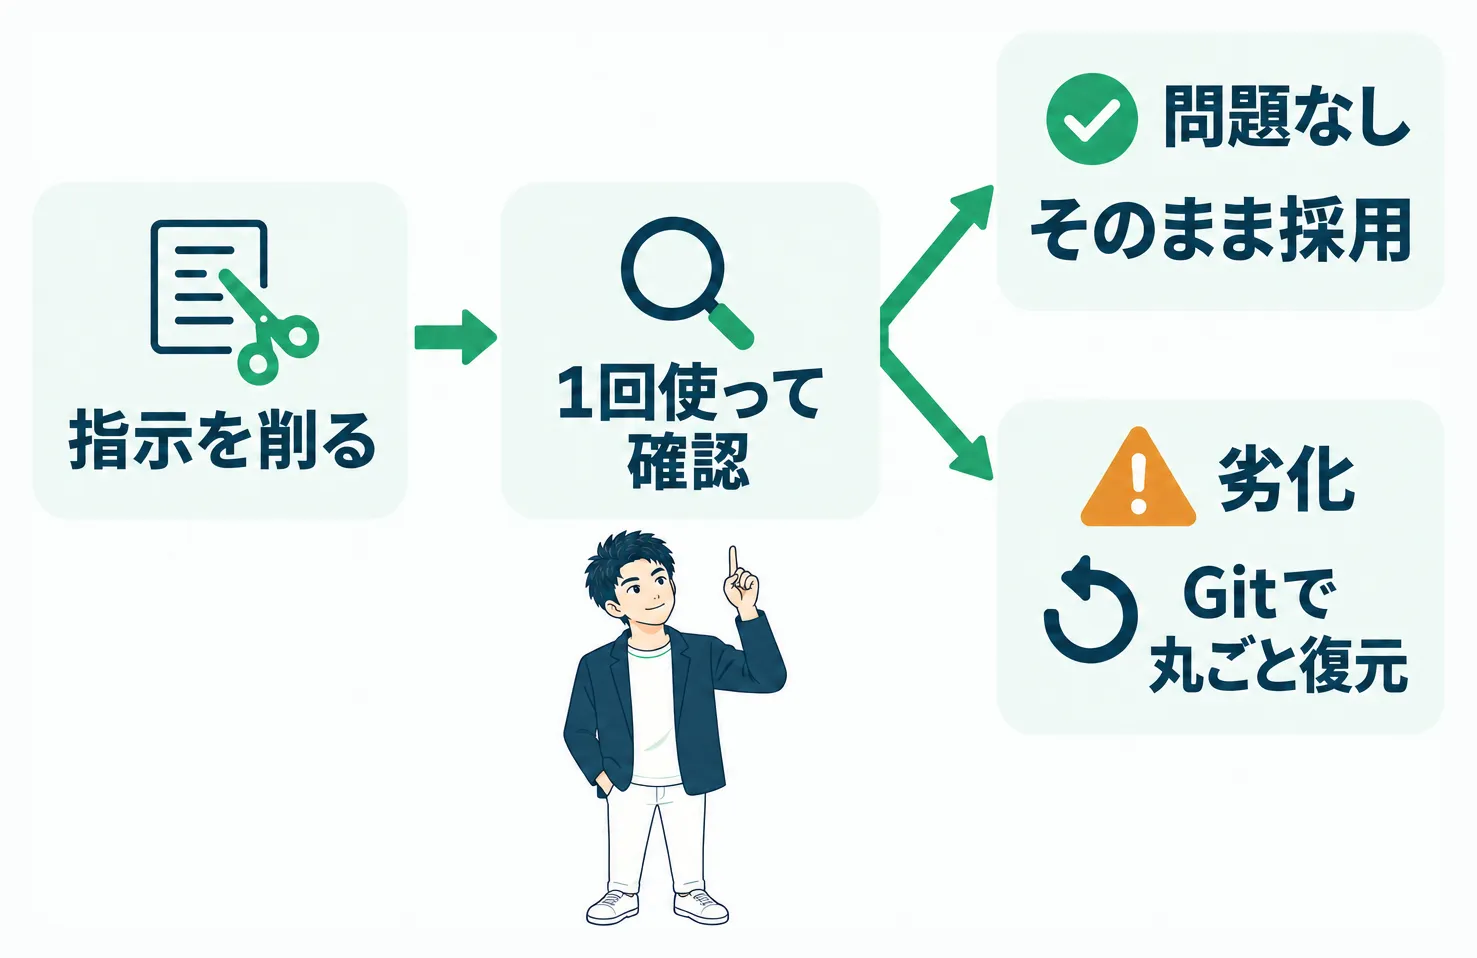
そんなに一気にスキルの内容を削って大丈夫なのか、心配な方もいると思います。ですが、削った後に1回使ってみて、結果を確認すれば問題ありません。
もし思い通りの結果にならなくても、最適化を丸ごと元に戻せばOKです。バージョン管理システムのGit(無料)でスキルを管理していれば、元に戻すのは簡単です。
Gitの使い方は、非エンジニアのためのGit入門で解説しています。
まとめの前に、お知らせを。
無料メルマガで実務で使えるAI活用を毎日配信中。1分で登録できます。
 超実践AI論Substacktaichiaiworker.substack.com
ながら聞きで、AIを仕事に活かす方法がわかるポッドキャストをSpotifyでも配信しています。
 超実践AI論Spotifyopen.spotify.com
まとめ:賢いAIは短い指示でより良い結果を出す
この記事の要点は次の4つです。
- Fable 5やAstraなどの賢いモデルには、これまでのAIに必要だった注意・判断・検証の指示が邪魔になる
- OpenAI公式ブログのリンクとスキルをAIに渡して、最適化してもらう
- 最適化したら1回スキルを使い、思い通りの結果になるかを確認する
- 成果物が劣化したら、最適化を丸ごと元に戻す。Git管理していれば簡単
ぜひあなたも、自分のスキルを1つ、OpenAI公式ブログのリンクを使って最適化してみてください。スキルがスリムになり、実行時間もトークンも、場合によっては成果物の品質も改善するはずです。
この記事をシェア